Распознавание речи преобразует аудиосигнал в последовательность слов. Современная AI-система не «слушает» запись как человек: она переводит звук в числовое представление, находит закономерности, сопоставляет их с языковым контекстом и выбирает наиболее вероятный текст. Для видео к результату добавляются временные метки, разделение на реплики и оформление субтитров.
Транскрибация видео — это итоговый текст, а AI-субтитры представляют его короткими блоками, синхронизированными с изображением и речью. Как этот путь выглядит для автора ролика — от загрузки до экспорта, — разобрано в статье автоматические субтитры для видео. Здесь — о том, что происходит внутри модели.
Как работает распознавание речи по этапам
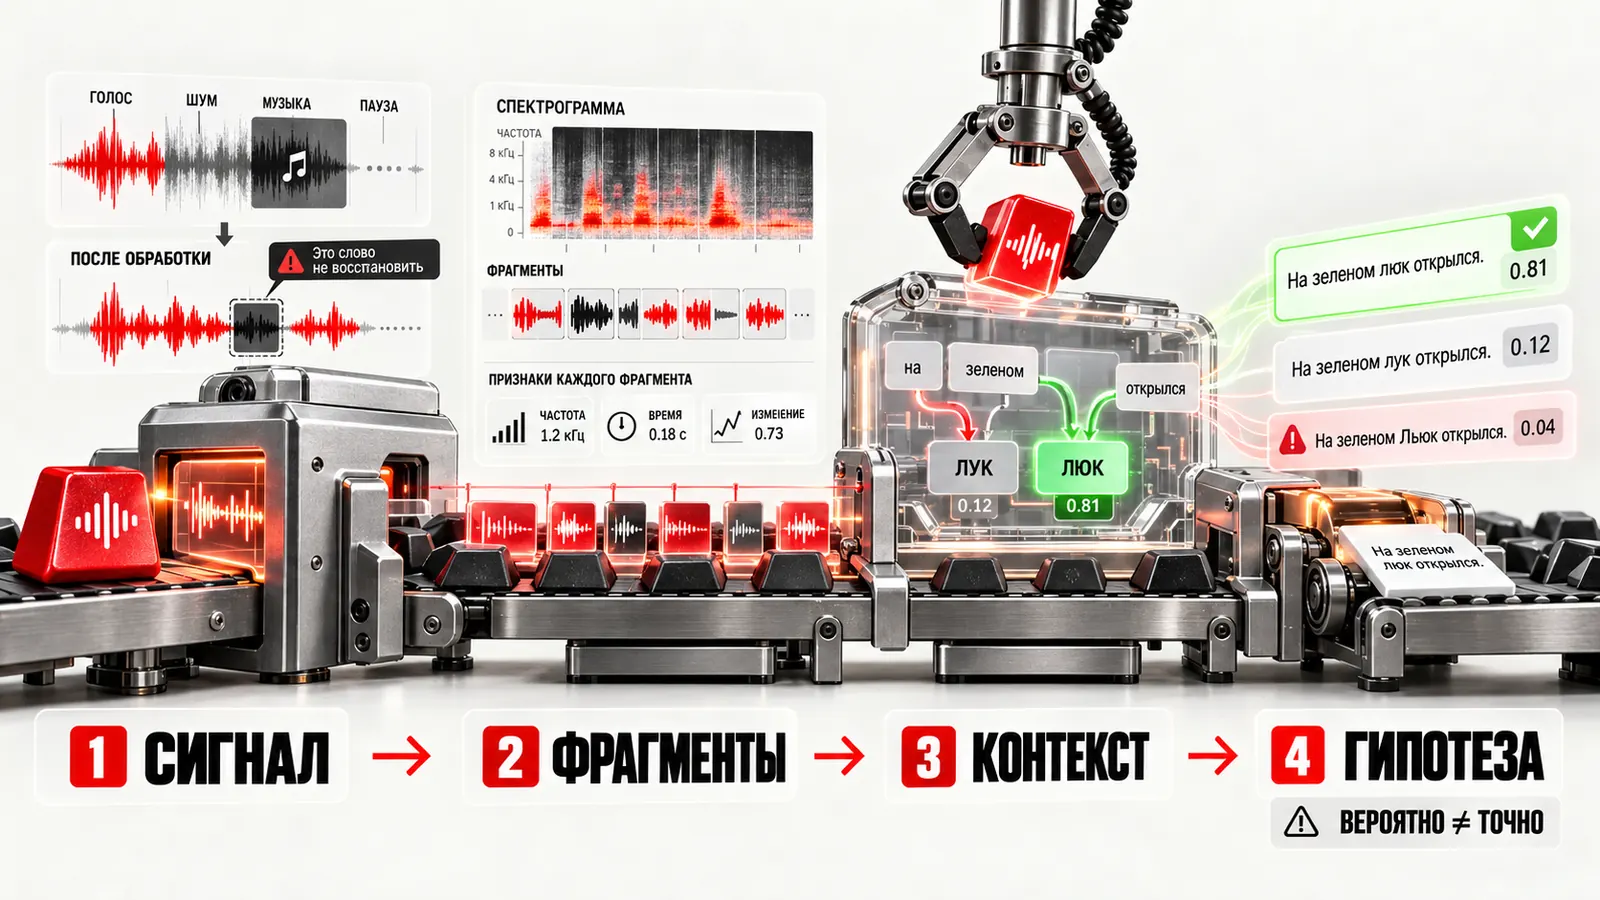
Сигнал → фрагменты → контекст → гипотеза
Сигнал. Сначала система извлекает звуковую дорожку и приводит её к формату, подходящему для анализа. Она может выровнять громкость, определить участки с голосом и отделить длинные паузы. Шумоподавление способно улучшить сигнал, но не восстановит слова, полностью перекрытые музыкой или другим спикером.
Фрагменты. Затем аудио делится на короткие отрезки. Модель преобразует их в числовые признаки, отражающие частоты, длительность и изменения звука во времени. В современных нейросетях эти признаки формируются внутри модели: она учится находить элементы сигнала, которые помогают различать звуки речи, границы слов и особенности произношения.
Контекст. Следующий этап — декодирование. AI оценивает не отдельный звук сам по себе, а его связь с соседними фрагментами. Один и тот же набор звуков может соответствовать разным словам, поэтому системе нужен контекст. Языковая часть модели повышает вероятность последовательностей, характерных для выбранного языка, и снижает вероятность бессвязных сочетаний.
Гипотеза. На выходе декодер формирует вариант текста. У системы может быть несколько кандидатов, различающихся одним словом или окончанием. Она выбирает наиболее вероятный, однако вероятность не равна фактической точности. Редкое имя, артикул или профессиональный термин иногда заменяются знакомым сочетанием, которое грамматически выглядит убедительно.
Чем AI-распознавание отличается от старых систем
Классические решения строились из отдельных модулей: акустической модели, словаря произношений и языковой модели. Каждый компонент требовал собственной настройки.
Современные модели часто обучаются преобразовывать длинный фрагмент аудио в текст как единую задачу. Архитектуры на основе трансформеров лучше учитывают удалённый контекст и могут работать с разными языками в одной модели.
При этом название нейросети не гарантирует одинаковый результат в разных сервисах. На точность влияют версия модели, способ обработки файла, выбранный язык, длина анализируемых сегментов и дополнительная обработка текста.
Как появляются тайм-коды и AI-субтитры
Обычная расшифровка может существовать как сплошной текст. Для субтитров нужно определить, когда начинается и заканчивается каждая реплика. Система связывает распознанные слова с участками звуковой дорожки и формирует временные интервалы. Затем текст делится на блоки подходящей длины.
Автоматическое деление не всегда совпадает со смыслом. Фраза может закончиться уже в следующем кадре, имя отделиться от фамилии, а отрицание перейти на другой экран. Поэтому создание субтитров включает не только распознавание речи, но и редактуру сегментов, пунктуации и тайминга.
Пунктуация обычно восстанавливается по контексту, паузам и интонационным признакам. Если в записи несколько участников, отдельная модель может выполнять диаризацию — определять, где меняется говорящий. Диаризация не устанавливает личность человека: она размечает условных участников, например «Спикер 1» и «Спикер 2», а имена затем добавляет редактор. Как оформлять такие диалоги, рассказываем в статье про субтитры для подкастов.
Почему нейросеть ошибается
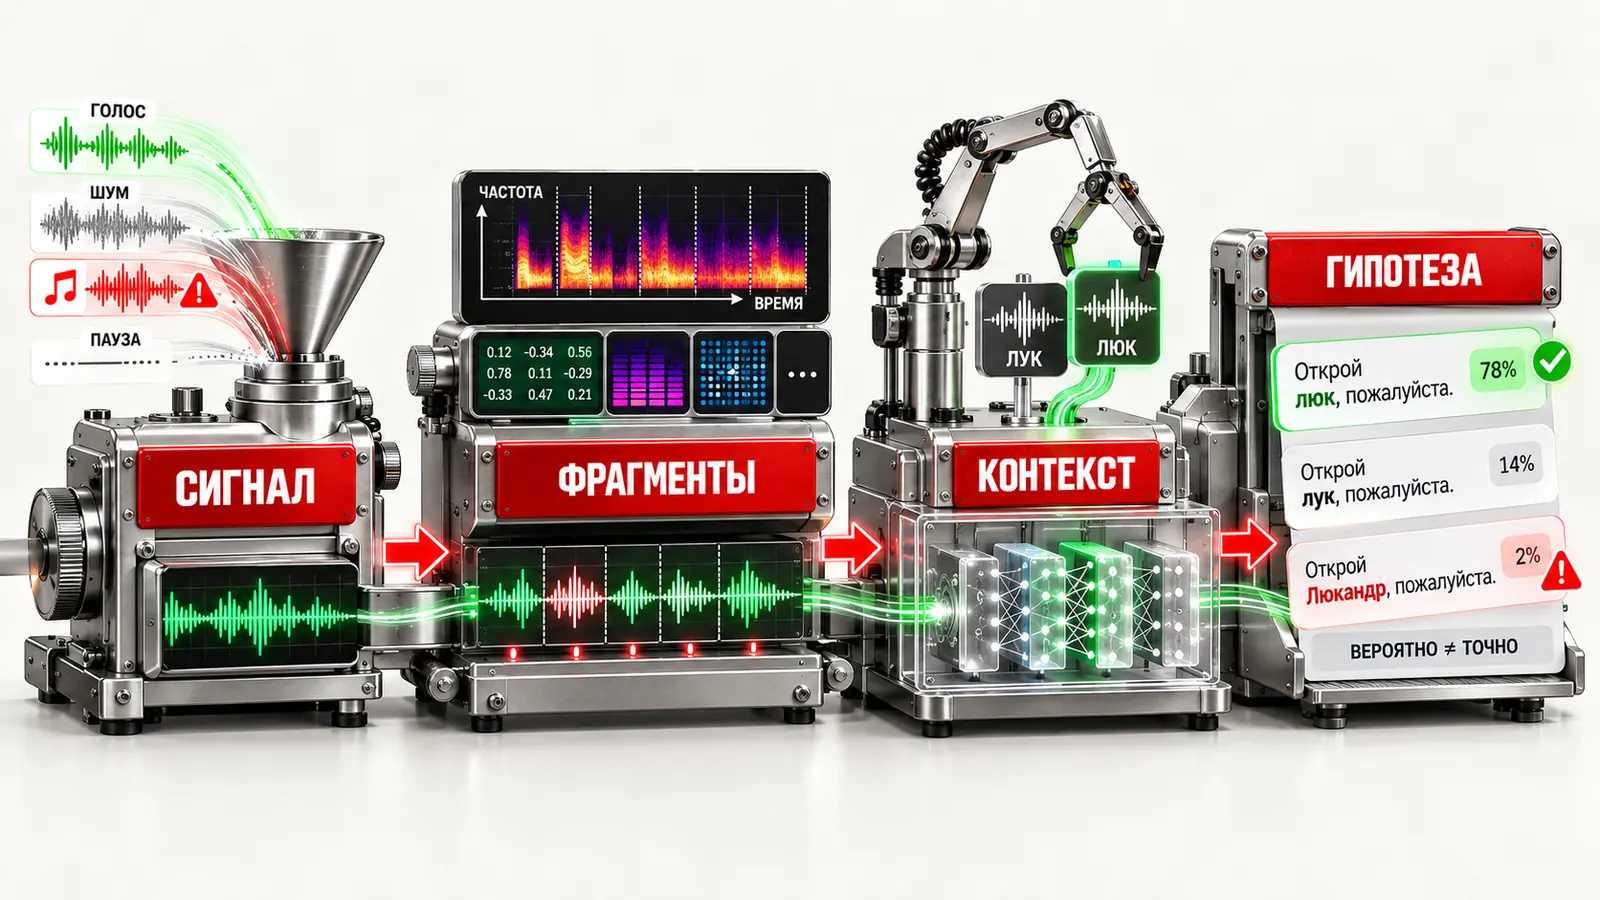
Модель выбирает самый вероятный вариант — не обязательно верный
Главная причина — неоднозначность сигнала. Микрофон фиксирует голос вместе с эхом, шумом комнаты, музыкой и чужими репликами. Чем меньше различий между полезным сигналом и фоном, тем больше возможных интерпретаций. Быстрая речь, проглоченные окончания, акцент и плохая связь тоже снижают точность.
Вторая причина связана с данными обучения. Если определённая лексика редко встречалась в примерах, модель хуже распознаёт названия препаратов, фамилии, локальные бренды и профессиональные сокращения. Контекст иногда помогает угадать слово, но может и создать правдоподобную ошибку.
Третья причина — неверно выбранный язык. Русская речь с английскими терминами, смешение языков и транслитерация сложнее одноязычной записи. Автоматическое определение языка удобно, но для короткой или шумной реплики может сработать неверно.
AI также не знает, что автор хотел сказать. Если человек оговорился, перепутал число или неверно произнёс название, система может точно записать ошибочную речь. Поэтому расшифровку иногда нужно сверять не только со звуком, но и со сценарием, изображением или исходными данными. Типичные ошибки и их причины подробнее разобраны в статье ошибки при создании субтитров.
От чего зависит качество транскрибации
Для личной заметки допустимы небольшие неточности, но образовательный ролик, инструкция или юридически значимая запись требуют проверки каждой цифры, фамилии и отрицания.
Процент точности без описания теста малоинформативен. Разные записи содержат разную лексику, темп и качество звука. Результат на студийном интервью нельзя автоматически переносить на конференцию, телефонный разговор или съёмку на улице.
Важна и задача пользователя. Для поиска нужного фрагмента достаточно приблизительной расшифровки. Если текст станет основой перевода, статьи или субтитров, ошибки перейдут во все следующие материалы.
Почему автоматический текст нужно проверять
AI создаёт вероятную версию сказанного, а не подтверждённый первоисточник. Ошибка может быть очевидной, но иногда результат выглядит грамотно и меняет факт незаметно. Особенно важно сверять имена, числа, единицы измерения, отрицания и последовательность действий.
Для проверки используйте финальную версию видео. Если после транскрибации удалить паузу или переставить сцену, временные метки перестанут соответствовать изображению. Текст читают вместе со звуком, а готовые субтитры дополнительно просматривают без звука, чтобы оценить понятность и темп.
Различайте ошибку распознавания и ошибку исходной речи. В первом случае система неверно записала произнесённое слово. Во втором запись получена правильно, но сам спикер назвал неправильное число или термин.
Как распознавание устроено в Captions Space
В Captions Space речь распознаёт модель Whisper, а отдельная модель wav2vec2 сверяет каждое слово со звуком и даёт пословные тайм-коды — поэтому подсветка активного слова совпадает с голосом. Сервис выполняет техническую часть быстрее ручного набора, но решение о правильности имени, термина или числа остаётся за редактором.
После распознавания сначала исправьте содержание и только затем настраивайте шрифт, положение и анимацию. Такой порядок снижает риск многократно редактировать уже оформленные блоки.
Для повторного использования можно сохранить файл субтитров, а для социальных сетей — экспортировать версию со вшитым текстом. Если после этого меняется монтаж, синхронизацию нужно проверить заново.
Как оценить готовый результат
Проверка должна отвечать на несколько вопросов:
- совпадает ли текст с фактической речью;
- правильно ли записаны имена, цифры и термины;
- не потеряны ли отрицания и условия;
- верно ли разделены спикеры;
- появляются ли реплики одновременно с голосом;
- можно ли понять видео без звука.
Отдельно проверьте начало, середину и конец записи, смену участников, участки с музыкой и перечислениями. Для ответственного материала выборочного просмотра недостаточно: один правильно распознанный фрагмент не подтверждает качество всего файла. Пошаговая методика, включая расчёт WER, — в инструкции как проверить точность субтитров.